IA, données et automatisation
Transformez vos données opérationnelles en décisions, et les tâches répétitives en automatisation fiable
La plupart des organisations disposent déjà des données nécessaires pour mieux fonctionner ; elles sont simplement dispersées entre systèmes, fichiers et boîtes mail. Nous relions ces données, les rendons fiables et les mettons au service de tableaux de bord, de workflows automatisés et d’une IA au périmètre maîtrisé, qui assiste les équipes sans se substituer à leur jugement.
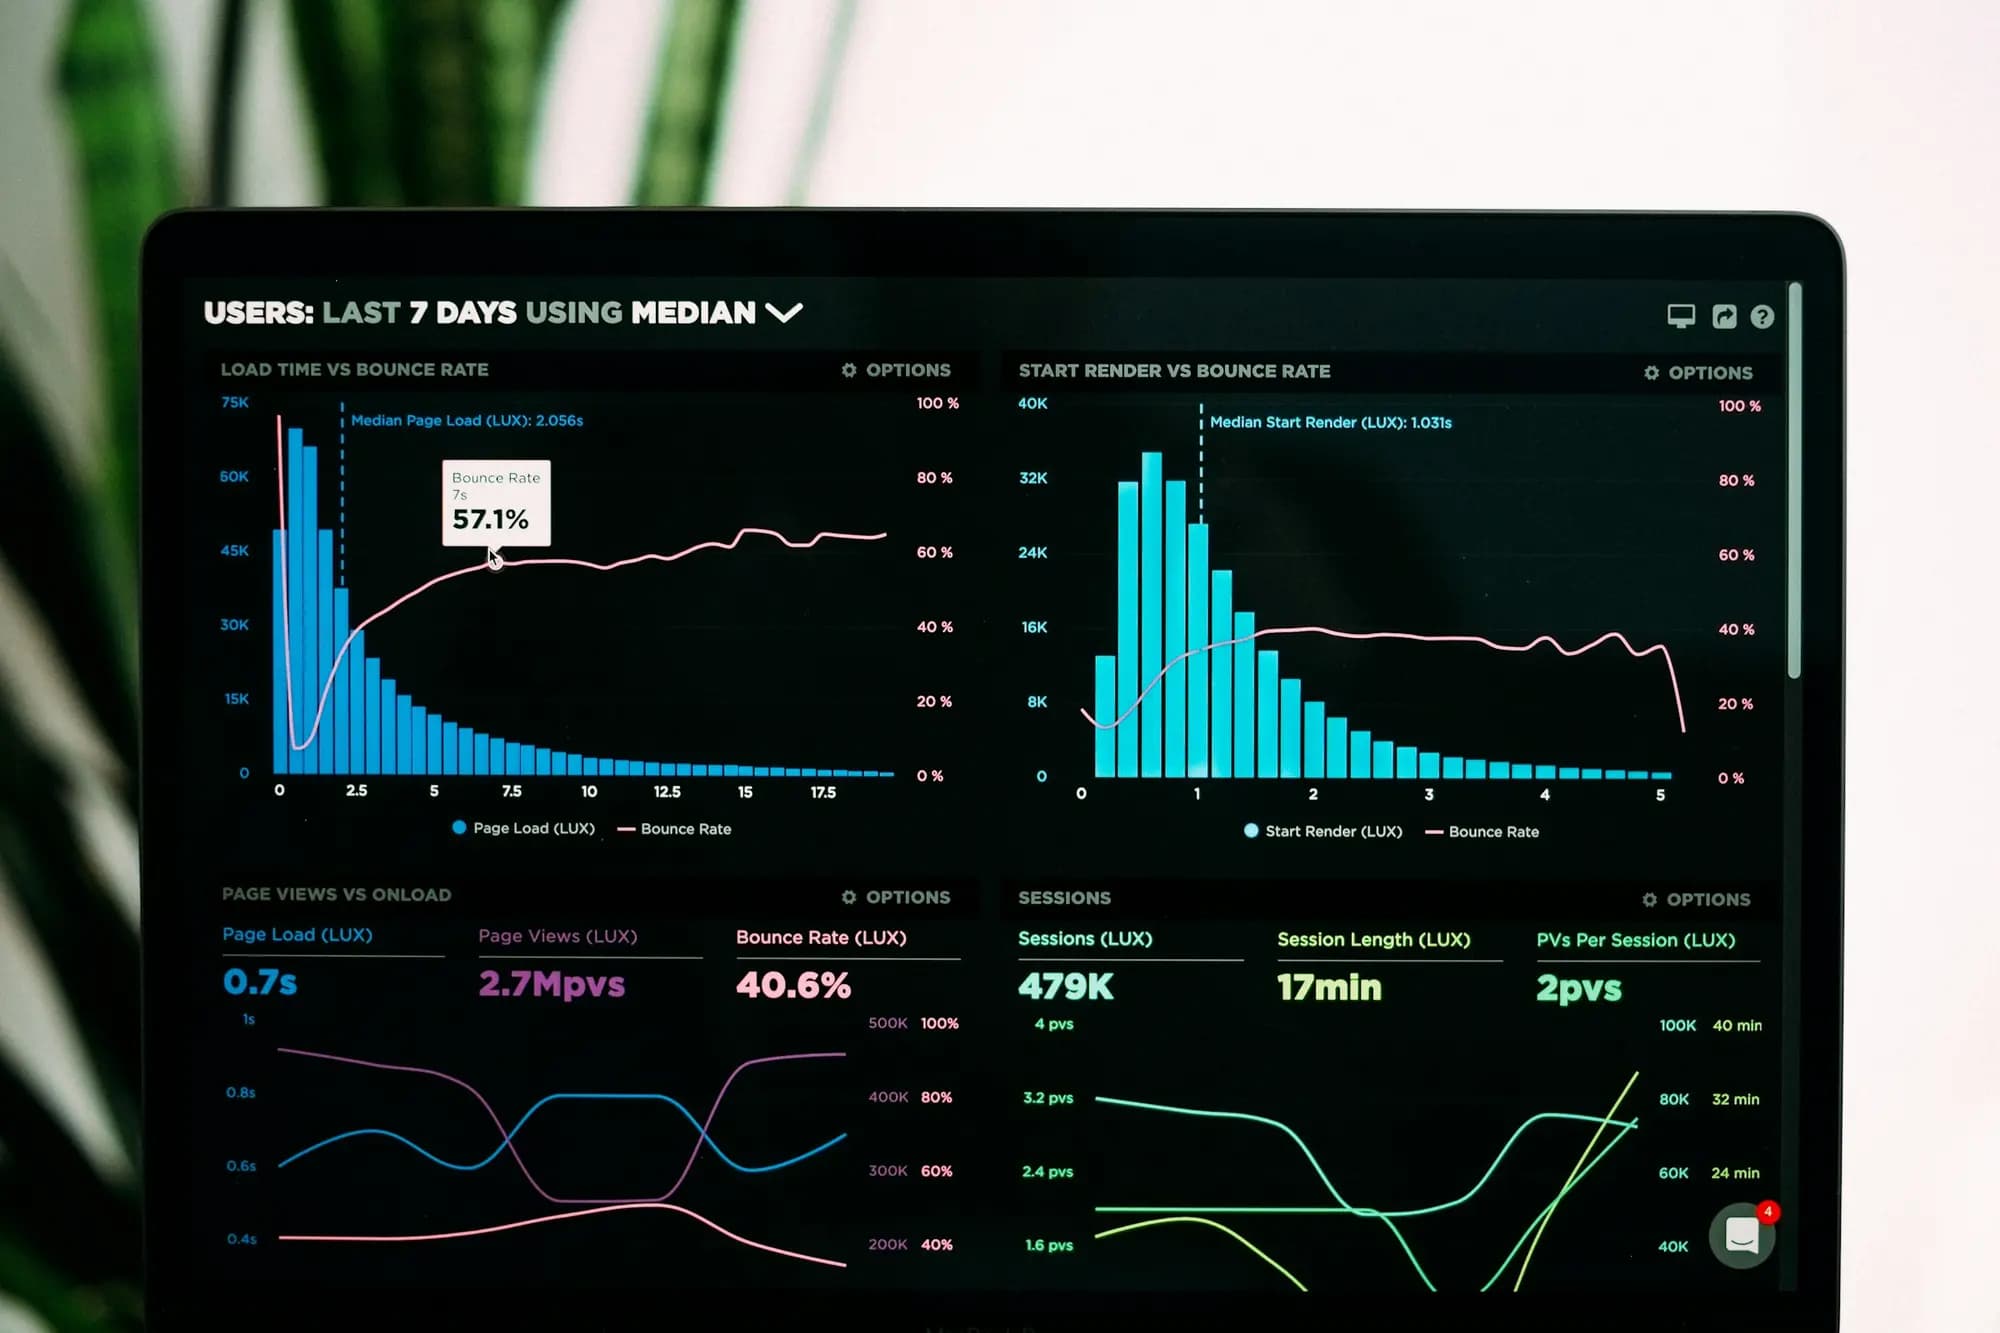
IA, données et automatisation
L’enjeu
Beaucoup de données, peu d’informations exploitables
Le reporting repose souvent sur quelques personnes qui exportent des données de plusieurs systèmes pour les assembler dans des tableurs. Les chiffres arrivent tard, les définitions varient d’un service à l’autre et personne ne s’y fie entièrement. Pendant ce temps, les équipes consacrent des heures à des tâches répétitives : saisie de factures, contrôle de formulaires, copie de données d’une application à l’autre.
L’IA promet de les soulager, mais de nombreuses initiatives s’enlisent parce que les données sont incomplètes, le cas d’usage flou ou les risques mal maîtrisés. Sur des marchés où les infrastructures de données se structurent encore, comme dans une grande partie de l’Afrique, les fondations comptent d’autant plus : l’intégration et la qualité des données passent avant tout modèle.
- Des rapports de direction compilés à la main et livrés plusieurs jours après la clôture
- Des chiffres contradictoires pour un même indicateur entre finance, ventes et opérations
- Du temps perdu à saisir des factures, formulaires et documents scannés
- Des prévisions fondées sur l’intuition faute d’accès simple à l’historique
- Des pilotes d’IA qui n’atteignent jamais la production ou dont personne n’est responsable
Capacités
Ce que nous concevons et développons dans ce domaine.
Intégration de données
Des pipelines qui extraient, nettoient et consolident les données de l’ERP, du CRM, des paiements, de la logistique et des systèmes historiques dans un entrepôt gouverné.
Informatique décisionnelle
Tableaux de bord et reporting en libre-service fondés sur des définitions d’indicateurs partagées, pour que chaque équipe lise les mêmes chiffres.
Automatisation des workflows
Validations, notifications, transferts de données et tâches de back-office automatisés, avec gestion des exceptions et traçabilité complète.
Analyse prédictive
Prévision de la demande, signaux d’attrition, indicateurs de risque de crédit et maintenance prédictive, validés sur l’historique avant toute utilisation.
Traitement intelligent des documents
Extraction des données de factures, reçus, pièces d’identité et formulaires, avec indice de confiance et validation humaine si nécessaire.
Opérations assistées par l’IA
Des assistants qui aident les équipes à rechercher dans la documentation interne, rédiger des réponses ou résumer des dossiers, à partir de vos contenus validés.
Gouvernance des données
Catalogue de données, responsables désignés, règles de qualité, traçabilité et politiques d’accès pour des données fiables et conformes.
Supervision humaine et IA responsable
Files de revue, explicabilité, contrôle des biais et surveillance continue : les personnes restent responsables des décisions qui touchent clients et collaborateurs.
Exemples de cas d’usage
Exemples illustratifs de la manière dont ces capacités peuvent être mises en œuvre.
- 01 · Directions générales et financières
Reporting de direction pour un groupe
Un groupe multi-entités pourrait consolider ventes, trésorerie et données opérationnelles de plusieurs systèmes dans des tableaux de bord quotidiens aux définitions partagées, au lieu de dossiers mensuels assemblés à la main.
- 02 · Équipes comptabilité fournisseurs
Traitement des factures et reçus
Une équipe finance pourrait recevoir les factures fournisseurs par e-mail ou par scan, en extraire automatiquement montants et références, et ne valider que les documents sur lesquels le système a un doute.
- 03 · Enseignes et distributeurs
Prévision de la demande pour le réassort
Un distributeur pourrait prévoir la demande par site à partir de l’historique des ventes et de la saisonnalité, et proposer aux acheteurs des quantités à commander qu’ils ajustent librement.
- 04 · Service client et opérations
Assistant documentaire pour le support
Une équipe support pourrait interroger procédures, politiques et fiches produits via un assistant qui cite ses sources et passe la main lorsqu’il ne dispose pas d’une réponse fiable.
Approche technique
Notre démarche pour des données et une IA responsables
Pour nous, l’IA est un outil parmi d’autres. Beaucoup de problèmes se règlent avec des données propres et une automatisation simple ; lorsque l’apprentissage automatique apporte une vraie valeur, nous le déployons avec des limites claires et des responsabilités définies.
- 01
Cadrer la décision
Nous partons d’une décision ou d’une tâche précise, définissons ce qu’est un bon résultat et vérifions que les données nécessaires existent et peuvent être utilisées.
- 02
Bâtir les fondations de données
Nous intégrons les sources, modélisons les données, appliquons des contrôles de qualité et documentons leur traçabilité pour que chaque rapport ou modèle repose sur une base solide.
- 03
Automatiser et modéliser par étapes
Nous livrons d’abord une automatisation à base de règles lorsqu’elle suffit, puis introduisons des modèles évalués par rapport à une référence et sur des jeux de test réels.
- 04
Garder l’humain dans la boucle
Nous définissons où les personnes relisent, corrigent ou valident les résultats, surveillons performances et dérives en production, et réentraînons ou revenons en arrière si nécessaire.
Technologies & pratiques
- Pipelines ELT
- Entrepôt de données
- Modélisation de données type dbt
- Orchestration de workflows
- Python
- OCR et IA documentaire
- Grands modèles de langage avec recherche augmentée
- Supervision des modèles
- Outils de BI et de tableaux de bord
Sécurité & passage à l’échelle
Gouvernance, confidentialité et montée en charge
Les systèmes de données et d’IA amplifient la valeur comme les risques. Nous les concevons pour protéger les données sensibles, garder des résultats explicables et absorber la croissance de manière prévisible.
Accès selon la finalité
L’accès aux données est accordé selon le rôle et la finalité, et les champs sensibles sont masqués ou pseudonymisés dans les environnements d’analyse.
Usage encadré des modèles d’IA
Nous vérifions où les données sont traitées, empêchons l’utilisation de données confidentielles pour entraîner des modèles tiers et privilégions les fournisseurs aux conditions claires.
Résultats traçables
Prédictions, extractions et contenus générés sont journalisés avec leurs entrées et la version du modèle, pour que chaque résultat puisse être revu et expliqué.
Garde-fous et évaluation
Tests automatisés, filtres de contenu et évaluations régulières détectent la dégradation de la qualité, les biais et les réponses inappropriées avant qu’ils n’atteignent les utilisateurs.
Traitements élastiques
Pipelines et services d’inférence s’adaptent aux volumes de données et sont planifiés pour maîtriser les coûts d’infrastructure.
Questions fréquentes
Par où commencer avec l’automatisation ou l’IA ?
Commencez par une tâche fréquente et bien comprise, où les erreurs ou les délais coûtent cher, comme le traitement des factures ou le reporting de direction. Il vaut généralement mieux régler d’abord l’accès aux données et leur qualité, puis automatiser, et n’ajouter l’apprentissage automatique que là où il améliore nettement le résultat.
L’IA remplace-t-elle les décisions de nos équipes ?
Pas dans les systèmes que nous concevons. L’IA suggère, extrait ou hiérarchise ; les personnes restent responsables des décisions qui concernent clients, collaborateurs ou finances, avec des mécanismes clairs de revue et de correction.
Nos données sont-elles protégées avec les grands modèles de langage ?
Nous concevons nos solutions pour que les données confidentielles soient traitées dans un cadre contractuel adapté, ne servent pas à entraîner des modèles tiers et restent réservées aux utilisateurs autorisés. Lorsque les exigences sont strictes, des modèles auto-hébergés ou hébergés dans la région peuvent être envisagés.
Pouvez-vous exploiter des données issues de systèmes anciens et de tableurs ?
Oui. L’intégration de bases historiques, d’exports de fichiers et de tableurs est souvent la première étape. Nous construisons des pipelines qui nettoient et normalisent ces données pour un usage fiable.
Solutions associées
Cloud et ingénierie logicielle
Ingénierie de bout en bout de plateformes web, mobiles et API sur des fondations cloud-native, avec les pratiques qui les rendent fiables.
En savoir plusERP et systèmes de gestion
ERP et systèmes de gestion sur mesure qui relient achats, stocks, finance et RH dans un flux unique, maîtrisé et auditable.
En savoir plusSupply chain et logistique
Des systèmes de transport, d’entreposage et de livraison qui offrent une vision fiable des flux, du fournisseur jusqu’au client final.
En savoir plus
Gombe, Kinshasa, DR CongoPhoto: MONUSCO/Abel Kavanagh — CC BY-SA 2.0
Contact
Parlons de votre projet.
Décrivez-nous votre contexte et vos contraintes : nous vous dirons comment nous l’aborderions.